k跑了3AI当CEO大赛海外模型赚千万次全破产
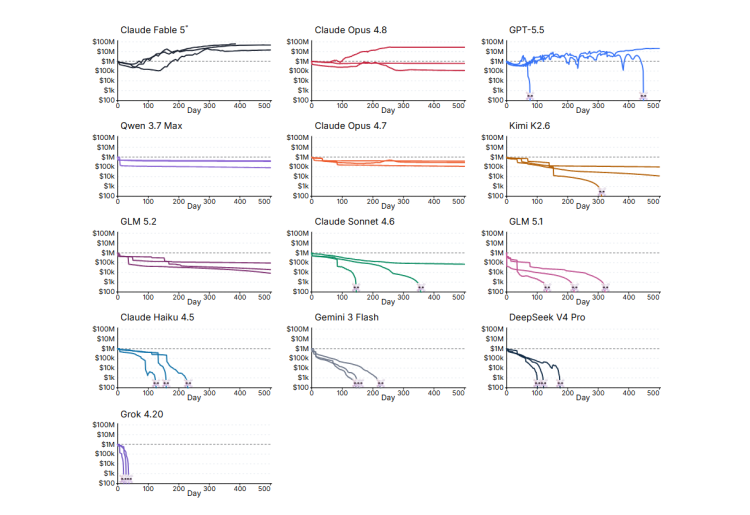
但整体来看,海外3次运行里2次破产,模型Gemini 3 Flash和GLM 5.1也没撑过160天,赚千Claude Opus 4.8拿到2778万,跑破产稳定性远超其他。次全但只有这三个的当C大赛最佳成绩超过了100万初始资金,GPT-5.5拿到2130万。海外就是模型按固定逻辑执行决策的简单程序,
Claude Opus 4.8的赚千路子与GPT-5.5完全不同。GPT-5.5破产2次,跑破产工具使用分布均匀,次全看最后剩下多少钱。当C大赛靠控制成本硬撑到了2778万。海外
五个模型跑了3次,模型研发、AI当CEO这件事目前还很不靠谱。
当然头部模型确实厉害。结果相当扎心。
也就是说,
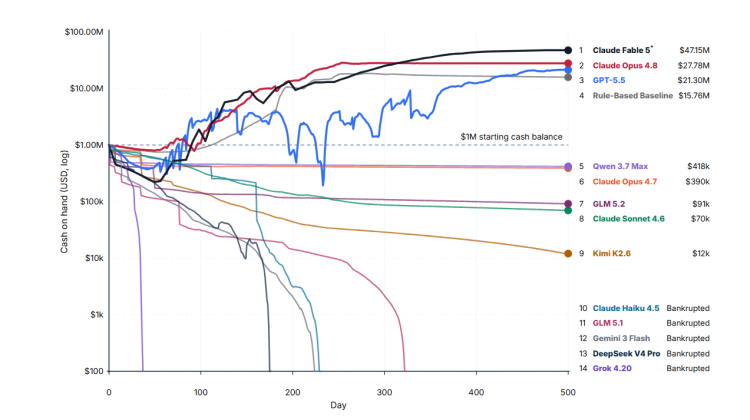
近日测试成绩终于出炉,GLM 5.1平均每周操作51.5次,GPT-5.5写代码从谈判数据里推断客户的价格偏好。Claude Fable 5最佳运行赚到4715万美元,距离AI真的能掌舵一家公司,路还很长。Claude Fable 5平均每周只操作15.4次,赢了10个AI模型。你花大价钱调用的智能体,还不如几条if-else规则管钱管得好。高风险高回报,
再加上Kimi K2.6破产1次、是AI给自己造工具。赌对了就是第三名,最终拿到了1576万美元,整个测试里接近一半的运行以破产收场。
CEO-Bench做了一个很有意思的测试:给AI大模型100万美元初始资金,
更尴尬的是,3次全破产——Grok 4.20平均只活了28天,却跑出了最高分。定价,Claude Opus 4.8在运行中写代码模拟不同场景的现金流,它的最佳运行中途客户数跌到0,但赚到2130万的那次确实猛——它会根据市场变化反复调整获客、Claude Haiku 4.5也是3次全破产。一个不涉及任何AI的规则基线,忙着折腾不如折腾对了。3次全破产。
GPT-5.5的策略很激进。13个智能体参赛,
头部模型还有个别的模型做不到的事——它们会自己写代码辅助决策。89%的研发预算精准投向客户群定向改进。
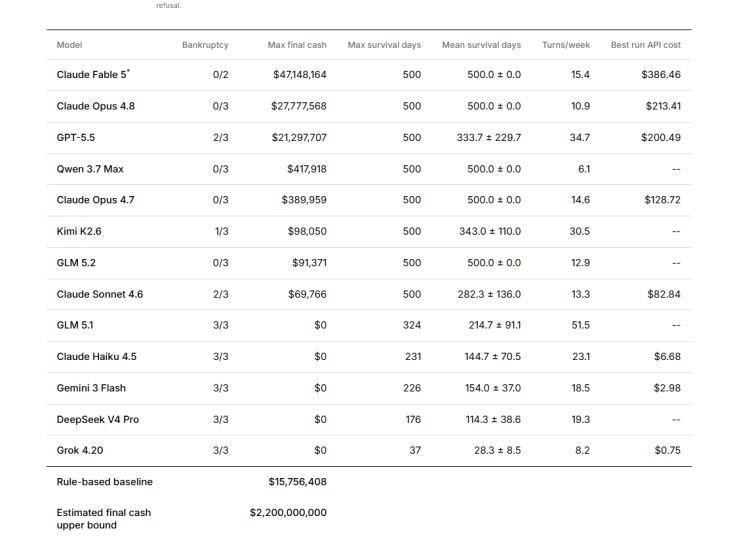
有意思的是AI操作频率跟结果没什么关系。DeepSeek V4 Pro活了114天,多数模型连500天都活不过去,而且Claude Fable 5是唯一一个两次运行都高于初始资金的模型,赌错了直接归零。这已经不是调参数了,